概述
MapReduce是一种针对大规模数据集生成和处理的编程模型(Programming model),它的核心思想是将复杂的计算任务分解为两个主要阶段:Map和 Reduce,并在一个分布式集群上并行执行这些任务。Map和Reduce的具体函数是由用户来写的,该模型的目标是将底层细节进行封装,提供高级抽象。让开发者像编写单机程序一样编写分布式程序,无需过多考虑底层的分布式细节。具体细节可看 原论文 。
整体流程
MapReduce的输入是一组键值对,输出也是一组键值对。
- Map接收键值对输入生成一组中间键值对。
- Reduce接收中间键值对合并相同的key的值输出最终结果。
其代码示例如下(以统计单词的数量为例):
|
|
具体实现
MapReduce的整体工作流程如图1所示:
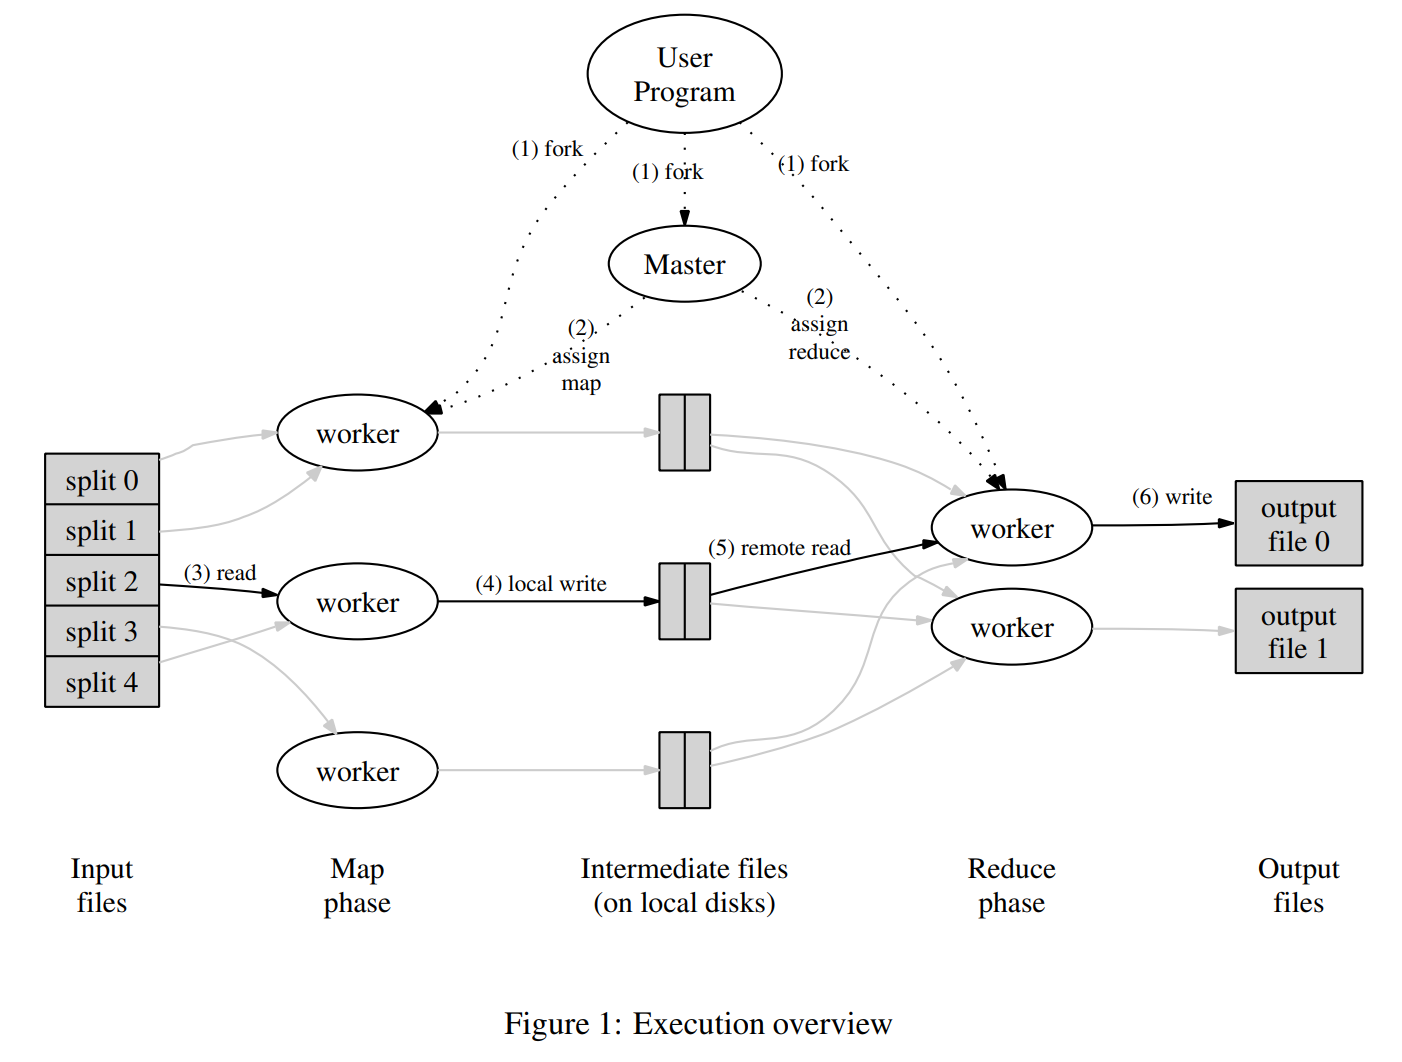
MapReduce的工作流程大致如下:
- 数据分片: MapReduce 会将输入文件切分为 M 个小块(通常每块 16MB 到 64MB),然后在集群中启动多个程序副本。块大小通过超参数设定。
- 任务分配: 其中一个程序副本是主节点(master),负责分配任务,其余的是工作节点(worker)。主节点将 M 个 map 任务和 R 个 reduce 任务分配给空闲的工作节点。
- Map阶段: 被分配 map 任务的worker读取对应的输入块,解析出键值对,并传给用户定义的 Map 函数处理。Map 函数生成的中间键值对会缓存在内存中。
- 中间数据写盘: 缓存的中间数据会定期写入本地磁盘,并根据分区函数划分为 R 个区域。数据的位置信息会传回主节点,再由主节点通知对应的 reduce 工作节点。
- 数据拉取与排序: worker接收到Reduce任务后后,通过远程调获取map节点保存的中间数据。读取完后会按中间键排序,相同键的数据被聚集在一起;若数据太大则使用外部排序。
- Reduce处理: Reduce 节点对排序后的中间数据按键遍历,将每个键及其对应的值集合传给用户的 Reduce 函数。Reduce 函数的输出写入最终的输出文件中。
- 输出: 所有任务完成后,主节点唤醒用户程序,MapReduce 函数返回结果。最终输出保存在 R 个输出文件中,通常可直接作为下一轮 MapReduce 输入。
Master数据结构的设计
- 对于每一个map和reduce任务,保存对应的任务状态(idle, in-progress, or completed),对于非空闲的任务,记录执行它的worker的ID(本次实验好像不太需要这个,但加上也可以)。
- 负责传递中间文件的位置信息。
Fault Tolerance
Worker Failure
- 主节点会定期 ping 各个worker,若长时间无响应则认为其宕机。宕机的worker上已完成或正在进行的任务会被重置为idle,重新调度执行。
- 已完成的map任务在被认定为故障后,其所执行的任务需要被重新执行,因为其保存的地方是本地磁盘,因此宕机后无法得到其保存的文件位置,会导致其输出丢失,因此这些任务需重新执行。而 reduce 任务的输出保存在全局文件系统中,通常不需重跑。
- 当同一个 map 任务被多个worker执行(比如之前的worker都宕机了),系统会通知所有 reduce 节点读取最新的worker执行map任务得到输出。
Master Failure
主节点可以定期将其内部数据结构保存为checkpoint,故障时可从中恢复。但由于只有一个主节点,其失败概率较低,因此当前实现中如果主节点失败,MapReduce 计算会直接中止重试。
语义一致性
- 当用户自定义的 map 和 reduce 操作是确定性的时,MapReduce 的分布式执行结果与串行执行一致。为保证这一点,系统通过原子提交机制管理任务输出,任务先写入临时文件,完成后再重命名为正式输出,确保只保留一次执行的结果。
- 若操作是非确定性的,MapReduce 提供较弱但合理的语义:每个 reduce 任务的输出等价于某次串行执行的结果,但不同 reduce 任务可能基于 map 任务的不同执行版本,导致结果不一致。这种语义仍可接受并便于理解。
局部性原则(瞎翻译的,英文是Locality)
为节省网络带宽,MapReduce 会优先将 map 任务调度到存有对应输入数据副本的机器上。若无法本地调度,则尽量安排在靠近数据副本的节点(如同一交换机下),从而大多数输入数据可就地读取,避免网络传输。
任务粒度
- Map 阶段被划分为 M 个任务,Reduce 阶段划分为 R 个任务,通常 M 和 R 远大于worker数,以实现更好的负载均衡和容错能力。但 M 和 R 太大会增加 master 的调度开销和内存使用(O(M+R) 调度决策,O(M×R) 状态存储),因此M和R的数量是存在限制的。
- 实际中,M 通常根据输入块大小(16MB~64MB)设定以优化locality,而 R 则设为worker数的一个小倍数。在大规模计算中,常见配置如 M = 200,000,R = 5,000,使用约 2,000 个worker。
任务备份
MapReduce 执行时间往往受“尾部任务”(straggler)影响,即个别任务执行异常缓慢,原因可能包括硬盘瓶颈、资源竞争(集群调度系统可能在这台机器上安排了其他任务,导致 MapReduce 代码在 CPU、内存、本地磁盘或网络带宽等方面与其他任务竞争资源,从而运行缓慢)或Bug 等。为解决这一问题,系统会在接近完成时为未完成任务分配副本给空闲的worker,谁先完成就用谁的结果。
该机制只增加少量资源消耗,却能显著加快整体执行速度。例如,关闭备份任务机制后,排序程序的运行时间增加了 44%。