简单看了下这个实验要求,实验的骨架结构已经搭好了,我们的主要任务就是完成coordinator.go、worker.go和rpc.go部分的代码实现论文中的内容。
coordinator.go:coordinator就是论文中的master,只有一个实例。负责协调整个MapReduce,肩负任务调度和状态监控的责任worker.go:可以启动多个实例。需要向 Master 请求任务,执行分配到的 Map 或 Reduce 任务,向 Master 报告任务完成或失败。rpc.go:主要是负责worker和coordinator之间的通信
整体流程#
worker主动向master发送通信,master通过判断目前的状态选择性的给worker分配任务以完成所有的map和reduce任务。具体而言:
- 初始化阶段:
Master 启动,它根据输入文件数量创建 nMap 个待分配的 Map 任务,并根据初始化参数准备nReduce个Reduce 任务。之后,多个工作进程 (Worker) 启动。
- 任务分配循环:
空闲的 Worker 通过 RPC 主动向 Master 请求任务。Master 收到请求后,优先分配待分配 (Pending) 的 Map 任务。如果所有 Map 任务都已开始(运行中或完成),则暂不分配任务让 Worker 等待(或稍后重试)。Master 会检测运行中 (InProgress) 但超时的任务,将其状态重置为 Pending(处理 Worker 故障)。
- Map 任务执行:
被分配到 Map 任务的 Worker 读取指定输入文件内容,调用用户定义的 Map 函数处理,生成一批键值对 (<key, value>)。然后,Worker 根据 Key 的哈希值(hash(key) % nReduce)将键值对划分为 nReduce 个分区,分别写入 nReduce 个临时中间文件。写入完成后,原子性地(原子操作)将每个临时文件重命名为约定的格式,确保下游任务要么看到完整文件,要么看不到。成功后通过 RPC 向 Master 报告完成。
- Reduce 任务分配与启动:
只有所有 Map 任务都报告完成后,Master 才会开始分配 Reduce 任务**。**
- Reduce 任务执行:
被分配到 Reduce 任务的 Worker 读取所有属于它的中间文件,使相同 Key 的键值对聚集在一起。然后,对于每个唯一 Key,将其和对应的所有 Value 列表传递给用户定义的 Reduce 函数进行处理。Reduce 函数的输出被写入一个临时输出文件。写入完成后,原子性地将其重命名为最终输出文件。完成后通过 RPC 向 Master 报告。
- 作业完成:
Master 持续监控所有 Map 和 Reduce 任务的状态。一旦它检测到所有 nMap 个 Map 任务和所有 nReduce 个 Reduce 任务都已完成,整个 MapReduce 作业即成功结束。Master 后续会指示 Worker 退出,自身的任务也宣告完成。最终结果存放在分散的
mr-out-Y 文件中(Y 从 0 到 nReduce-1)。故障处理(超时重试)贯穿整个过程。
代码设计#
首先最重要的就是worker向master发送信息时的请求参数和master返回的参数,我的设计如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
|
  // 任务类型
  const (
  	MapWork WorkType = iota
  	ReduceWork
  )

  type AskType int

  const (
  	AskTask  AskType = iota // 请求任务
  	Finished                // 报告任务完成
  	Failed                  // 报告任务失败
  )

  type ReplyType int

  // coordinator希望worker目前是什么状态。
  const (
  	Work ReplyType = iota // 分配工作
  	Exit                  // 退出
  	Wait                  // 等待
  )

  // 任务相关的参数
  type TaskParams struct {
  	TaskName  WorkType // 任务类型
  	MapNo     int      // map编号
  	ReduceNo  int      // reduce编号
  	AttemptId int      // 任务第几次被执行,便于检测是否是超时后重新传来的
  }

  type Args struct {
  	TaskInfo   TaskParams // 任务参数
  	AskMessage AskType    // 请求类型
  }

  type Reply struct {
  	TaskInfo     TaskParams // 任务参数
  	MapFile      string     // map所要执行的文件
  	ReduceNum    int        // reduce总共有多少个
  	ReplyMessage ReplyType
  }
|
我的coordinator的数据结构如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
|
  var MapCompleted, AllCompleted bool = false, false

  // 任务状态
  const (
  	Pending    TaskState = iota // 待分配
  	InProgress                  // 进行中
  	Completed                   // 已完成
  )

  // 任务相关参数
  type TotalTasks struct {
  	taskStates    []TaskState // 任务状态
  	LastHeartbeat []int64     // 上一次心跳时间
  	attemptId     []int       // 第几次尝试,当发送来的attemptID小于这里的保存时,证明是已经超
  }                           // 时的任务,直接放弃

  type Coordinator struct {
  	// Your definitions here.
  	mu          sync.Mutex
  	files       []string   // 每一个map任务对应的文件
  	mapTasks    TotalTasks // map任务
  	reduceTasks TotalTasks // reduce任务
  	exitTime    int64      // 退出时间,用于master退出前通知各个worker退出
  }
|
当worker开始执行时,会频繁的向coordinator发送消息以请求任务并根据返回的参数来决定下一步向coordinator发送什么消息:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
|
  func CallExample(mapf func(string, string) []KeyValue,
  	reducef func(string, []string) string) {

  	args := Args{}
  	args.AskMessage = AskTask

  	reply := Reply{}
  	call("Coordinator.Handler", &args, &reply)

  	for {
  		deal_reply(&args, &reply, mapf, reducef)
  		time.Sleep(time.Second)
  		reply = Reply{}
  		call("Coordinator.Handler", &args, &reply)
  	}

  }
  func deal_reply(args *Args, reply *Reply, mapf func(string, string) []KeyValue,
  	reducef func(string, []string) string) {
  	if reply.ReplyMessage == Work { // 有任务来了,就进行作业
  		var err error = nil
  		args.TaskInfo = reply.TaskInfo
  		if reply.TaskInfo.TaskName == MapWork {
  			err = map_file(reply.MapFile, mapf, reply.TaskInfo.MapNo, reply.ReduceNum)
  		} else if reply.TaskInfo.TaskName == ReduceWork {
  			err = reduce_file(reply.TaskInfo.ReduceNo, reducef)
  		}
  		if err == nil { // 任务顺利完成
  			args.AskMessage = Finished
  		} else { // 任务失败
  			args.AskMessage = Failed
  		}
  	} else if reply.ReplyMessage == Wait { // 暂时没有任务,继续请求
  		args.AskMessage = AskTask
  	} else if reply.ReplyMessage == Exit { // 被通知退出,之间退出即可
  		os.Exit(0)
  	}
  }
|
coordinator根据worker发来的消息,对不同的请求进行分发:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
|
  func (c *Coordinator) Handler(args *Args, reply *Reply) error {
  	var err error = nil
  	c.mu.Lock()
  	IsExit := AllCompleted
  	c.mu.Unlock()

  	if IsExit {
  		reply.ReplyMessage = Exit
  		return nil
  	}

  	switch args.AskMessage {
  	case AskTask:
  		err = c.askTask(args, reply)
  	case Finished:
  		err = c.taskFinished(args, reply)
  	case Failed:
  		err = c.taskFailed(args, reply)
  	}
  	return err
  }
|
coordinator每秒都会执行一次done(),我们在done中进行心跳检测,判断任务是否超时并检测所有的map和reduce任务是否完成,如果都完成了,就会准备退出,但在coordinator退出前会留出3s时间,接收worker的信息并通知worker退出:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
|
  func (c *Coordinator) Done() bool {
  	// ret := false

  	c.mu.Lock()
  	defer c.mu.Unlock()

  	mapState := c.testHeartBeat(&c.mapTasks)
  	reduceState := c.testHeartBeat(&c.reduceTasks)

  	if mapState {
  		MapCompleted = true
  	}
  	if mapState && reduceState {
  		AllCompleted = true
  	}

  	if AllCompleted {
  		if c.exitTime == 0 {
  			c.exitTime = time.Now().Unix()
  		} else if time.Now().Unix()-c.exitTime >= 3 {
  			return true
  		}
  	}

  	return false
  }
|
关于任务的分配:每次找到一个未分配的任务进行分配,并将其attemptID值返回给worker,当worker完成该任务返回时,需要检测该attemptID是否等于coordinator中保存的,若小于该值,则直接放弃。
当worker返回任务失败,或检测到任务超时时,会直接将该任务重新放回待分配队列,并将其attemptID加1,以避免失败的任务的干扰。
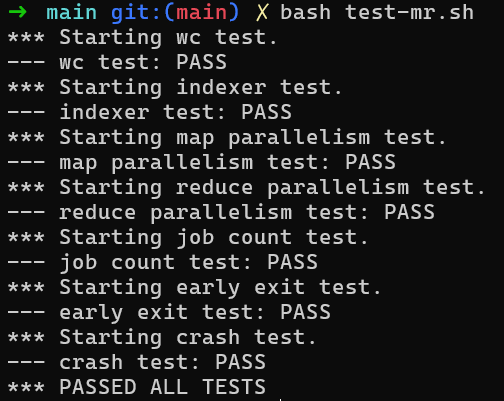
该代码测试了2000次都顺利完成了,但测完忘了截图,再跑一次太久了,就放一次的吧。
其实这次实验,我最大的感受就是这些实验好像也没有我想象的那么难,也是可以靠自己写出来的,虽然代码写的一坨,但给了我不少信心。
这里面还有很多可以优化的地方的,几乎所有涉及到共享变量都是一把大锁,之后也可以通过修改该代码学一下go的Channel。