在这部分中我们要在lab4的基础上更近一步,lab4是只有一组raft服务,lab5就是Multiraft(multi-group),进一步加入了分片的机制,主要用于解决在大规模分布式系统中高可用、强一致性、可扩展性等问题。
单 Raft Group 的局限性:
Raft 是一种用于实现分布式系统一致性的共识算法,通常以一个“Raft Group”(即一组节点共同维护一个日志副本)为单位工作。但在实际应用中,如果整个系统只用一个 Raft Group,有以下缺点:
- 写性能瓶颈: 所有的写请求必须由 Leader 单节点处理并定序,无法利用集群多节点的并发能力,吞吐量受限于单机资源。
- 扩展性受限: 增加节点仅能提升容灾能力,无法线性提升写性能,且集群总存储容量被限制在单机磁盘大小。
- 故障恢复慢与热点问题: 巨大的状态机导致快照生成和日志回放缓慢,故障恢复时间长;且单一 Group 难以进行细粒度的负载均衡,易形成读写热点。
分片 + 多 Raft Group:
Multiraft 将整个数据集划分为多个分片(shard),每个分片由一个独立的 Raft Group 负责管理。
- 每个 Raft Group 只负责一部分数据,互不影响;
- 写/读请求可以并行处理,提高系统吞吐;
- 系统可以通过增加分片数量来横向扩展;
- 故障隔离:某个 Group 出现问题(如网络分区、节点宕机),不会影响其他 Group。
shardctrler#
针对5A的实验,主要就是设计一个shardctrler,它的作用是维护集群的配置信息(Configuration),即负责管理“分片(Shard)”到“复制组(Replica Group / GID)”的映射关系,并在集群拓扑变化时自动进行分片的负载均衡(Rebalancing)。
具体来说,它需要通过 Raft 保证高可用和强一致性,并支持以下 4 个核心操作(RPC):
- Join (加入新组): 当新的复制组(Replica Group)加入集群时,Ctrler 需要将部分分片从现有组迁移给新组,以实现负载均衡。
- Leave (移出旧组): 当某个复制组想要离开集群时,Ctrler 需要将其持有的分片重新分配给剩余的组,确保数据不丢失且分布均匀。
- Move (手动迁移): 允许管理员强制将某个特定的分片(Shard)分配给特定的组(GID),主要用于调试或处理热点。
- Query (查询配置): 允许 ShardKV 节点或 Client 查询最新的或历史版本的配置(Config),以便知道读写请求该发往哪里。
它本身一个group,所以基本的接收命令然后提交等操作和之前完全一样,主要就是这四个操作和rebalance,注意rebalance要最少移动原则。
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
|
// 计算平均值,先剔除多余的或无效的分片,再将空闲分片分配给需要的新组
func (sc *ShardCtrler) rebalance(config *Config) {
	allNum := len(config.Groups)

	if allNum == 0 {
		for i := 0; i < NShards; i++ {
			config.Shards[i] = 0
		}
		return
	}

	var keys []int
	for key := range config.Groups {
		keys = append(keys, key)
	}
	sort.Ints(keys)

	avg := max((NShards / allNum), 1)
	remainder := NShards % allNum

	cnt := make(map[int]int, allNum)
	for i, gid := range keys {
		if i < remainder {
			cnt[gid] = avg + 1
		} else {
			cnt[gid] = avg
		}
	}

	for i := 0; i < NShards; i++ {
		gid := config.Shards[i]
		if gid == 0 {
			continue
		}
		if _, ok := config.Groups[gid]; !ok {
			config.Shards[i] = 0
			continue
		}
		if cnt[gid] == 0 {
			config.Shards[i] = 0
		} else {
			cnt[gid] -= 1
		}
	}

	freeG := list.New()

	type remain struct {
		gid int
		cnt int
	}

	for _, k := range keys {
		if cnt[k] > 0 {
			freeG.PushBack(remain{gid: k, cnt: cnt[k]})
		}
	}

	for i := 0; i < NShards; i++ {
		if config.Shards[i] == 0 {
			front := freeG.Front()
			value := front.Value.(remain)
			config.Shards[i] = value.gid
			if value.cnt == 1 {
				freeG.Remove(front)
			} else {
				value.cnt -= 1
				front.Value = value
			}
		}
	}

}

func (sc *ShardCtrler) getNewConfig() *Config {
	n := len(sc.configs)
	config := sc.configs[n-1]
	newConfig := config
	newConfig.Groups = make(map[int][]string, len(config.Groups))

	for k, v := range config.Groups {
		newConfig.Groups[k] = v
	}
	newConfig.Num = config.Num + 1
	return &newConfig
}

func (sc *ShardCtrler) applyJoin(servers map[int][]string) {
	newConfig := sc.getNewConfig()

	for k, v := range servers {
		newConfig.Groups[k] = v
	}

	sc.rebalance(newConfig)
	sc.configs = append(sc.configs, *newConfig)
}

func (sc *ShardCtrler) applyLeave(LeaveGIDs []int) {
	newConfig := sc.getNewConfig()

	for _, gid := range LeaveGIDs {
		if _, ok := newConfig.Groups[gid]; ok {
			delete(newConfig.Groups, gid)
		}
	}

	sc.rebalance(newConfig)
	sc.configs = append(sc.configs, *newConfig)
}

func (sc *ShardCtrler) applyMove(gid int, shard int) {
	newConfig := sc.getNewConfig()
	newConfig.Shards[shard] = gid
	sc.configs = append(sc.configs, *newConfig)
}

func (sc *ShardCtrler) applyQuery(num int) *Config {
	lastConfigIndex := len(sc.configs) - 1

	if num == -1 || num > lastConfigIndex {
		return &sc.configs[lastConfigIndex]
	} else {
		return &sc.configs[num]
	}
}
|
Shard Movement#
上一部分的实验(5A)主要完成了控制面的工作,即通过 ShardCtrler 维护集群配置和分片映射,但并没有涉及真正的数据面迁移。 这一部分(5B)的核心就是分片移动(Shard Movement):当配置发生变更时,节点之间需要通过网络传输分片数据。基础的 KV 存储逻辑可以复用 kvraft 的代码,但我们需要在其之上构建一套复杂的状态机流转机制。
分片状态#
由于每一组group负责的分片不同了,因此我们定义一下分片,来判断server是否对该分片提供服务,分片的状态定义如下:
1
2
3
4
5
6
|
const (
	Serving   ShardStatus = iota // 正常服务中
	Pulling                      // 正在从别人那拉数据 (不可读写)
	BePulling                    // 正在被别人拉数据
	GCing                        // 等待清理
)
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
func (kv *ShardKV) checkShard(key string) Err {
	shardID := key2shard(key)
	kv.mu.Lock()
	defer kv.mu.Unlock()

	if kv.currentConfig.Shards[shardID] != kv.gid {
		return ErrWrongGroup
	}

	if shard, ok := kv.data[shardID]; !ok || shard.State != Serving {
		return ErrNotServing
	}
	DPrintf(dAsk, "%v: have a ask, shardID is %d, pass check\n", kv, shardID)
	return OK
}
|
每一个分片到来前我们都要进行如上的检查,如果shard对应的owner不对或者不是serving状态下,就返回错误。这里其实还可以优化,就是旧owner如果在BePulling,完全可以提供读服务,但写一定要拒绝。
Config Update#
接下来就考虑分片的迁移:每个 Replica Group 都需要感知全局配置的变化,因此启动一个后台协程(Goroutine)定期监控配置变更(Config Polling)是整个迁移流程的起点。
后台监控线程不能直接把配置从 Config 1 跳到 Config 10。必须逐号更新。因为我们需要知道分片是从哪里来的。如果是从1跳到10,中间可能经历了多次变更,我们将丢失分片的“前任持有者”信息,导致无法去拉取数据。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
|
func (kv *ShardKV) monitorConfig() {
	for !kv.killed() {
		if kv.isLeader() {
			kv.mu.Lock()
			currentNum := kv.currentConfig.Num
			if !kv.allShardsReady() {
				kv.mu.Unlock()
				time.Sleep(100 * time.Millisecond)
				continue
			}
			kv.mu.Unlock()

			newConfig := kv.ctrClients.Query(currentNum + 1)
			DPrintf(dConfig, "%v: all shard ready, query next Config, next num is %d\n", kv, newConfig.Num)

			if newConfig.Num == currentNum+1 {
				kv.mu.Lock()
				if kv.currentConfig.Num == currentNum {
					kv.mu.Unlock()
					kv.startReconfiguration(newConfig)
				} else {
					kv.mu.Unlock()
				}
			}
		}
		time.Sleep(100 * time.Millisecond)
	}
}

func (kv *ShardKV) allShardsReady() bool {
	for shardID, gid := range kv.currentConfig.Shards {
		// 如果有任何一个分片正在拉取中,就不能升级 Config
		if gid == kv.gid && kv.data[shardID].State == Pulling {
			return false
		}
	}
	return true
}
|
可以看到上面这个代码,在我当前的实现中,进行了一个判断kv.allShardsReady(),这是因为比如分片S属于A,如果我们在 Config N+1 且需要分片S,但S还没从 A 拉过来,就直接跳到了 Config N+2,我们可能会忘记分片S目前还在 A 手里。组 C 会来找我们要数据,但我们自己也是空的,导致数据链条断裂,甚至丢失数据。 只有确保 Config N 的数据完整了,我们才有资格进入 Config N+1,甚至将来把数据传给别人。但是后续也可以优化,但难度会更高,就先这样做了。
当我们成功拉取到新配置后,一定不要直接应用,在raft中所有新数据都要先经过raft进行共识。当raft共识完成,即从appliar loop中接收到新的config后再应用:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
|
case InsertConfigOp:
  kv.notifyShard(index)
  if kv.currentConfig.Num+1 == command.Config.Num {
    oldConfig := kv.currentConfig
    kv.calcShardChange(&kv.currentConfig, &command.Config)

    DPrintf(dConfig, "%v: %d -> %d \n", kv, oldConfig.Num, command.Config.Num)

    kv.currentConfig = command.Config
    kv.currentConfig.Groups = make(map[int][]string)
    for k, v := range command.Config.Groups {
      kv.currentConfig.Groups[k] = v
    }
  }
|
当配置更新时,需要通过 calcShardChange 函数来对比新旧配置的差异,从而驱动分片的状态机流转。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
|
func (kv *ShardKV) calcShardChange(oldConfig *shardctrler.Config, newConfig *shardctrler.Config) {
	oldNum := oldConfig.Num

	kv.historyData[oldNum] = make(map[int]map[string]string)
	// 遍历所有的分片
	for shardID := 0; shardID < shardctrler.NShards; shardID++ {
		// 获取该分片在旧配置和新配置中的归属 GID
		oldGID := oldConfig.Shards[shardID]
		newGID := newConfig.Shards[shardID]

		if newGID == kv.gid && oldGID != kv.gid {
			if _, ok := kv.data[shardID]; !ok {
				kv.data[shardID] = &Shard{}
				kv.data[shardID].KV = make(map[string]string)
			}
			if oldGID != 0 {
				kv.needPulling[shardID] = copyConfig(*oldConfig)
				kv.data[shardID].State = Pulling
			} else {
				kv.data[shardID].State = Serving
			}
		}

		if oldGID == kv.gid && newGID != kv.gid {
			if kv.data[shardID].State == Serving {
				kv.data[shardID].State = BePulling

				kv.historyData[oldNum][shardID] = make(map[string]string)
				for k, v := range kv.data[shardID].KV {
					kv.historyData[oldNum][shardID][k] = v
				}
				DPrintf(dDrop, "%v: config num: %d Shard: %d is dropped\n", kv, oldNum, shardID)
			}
		}
	}

}
|
该函数主要处理两种核心场景:
- 分片转入 :
- 若发现某分片的新 Owner 是我,且旧 Owner 不是我,说明该分片需要迁移进来。
- 初始分配: 如果旧 Owner 是 0(集群刚启动),直接置为
Serving。
- 迁移分配: 如果来自其他 Group,置为
Pulling 状态,并记录数据来源(needPulling),等待拉取协程去获取数据。
- 分片转出:
- 若某分片的旧 Owner 是我,但新 Owner 不是我,说明该分片要离开。
- 状态切换: 将分片标记为
BePulling,表示停止服务但保留数据。
- 数据快照 (History Snapshot): 这是最关键的一步。我们需要将当前分片的数据进行深拷贝并保存到
historyData[oldNum] 中。这样即使当前节点后续覆盖了该分片的数据,新 Owner 依然可以通过 RPC 拿着旧配置号(oldNum)来拉取这份不可变的“历史快照”。
Shard Move#
在实现分片迁移时,一个常见的误区(我第一次写就是这么做的,调bug调了3天,,后来把日志的粒度写的非常细才发现)是在 calcShardChange 检测到配置变更后,立即在同一个逻辑流中发起 RPC 拉取数据。这种“事件驱动”的做法非常脆弱:如果网络抖动导致 RPC 失败怎么办?如果节点在拉取过程中崩溃重启了怎么办?这个“拉取事件”就会彻底丢失,导致分片永远处于不可用状态。
因此,我们需要牢记:分布式系统是基于状态机(State Machine)运作的,而不是基于瞬时事件。
1. 职责分离
我们将逻辑拆分为两部分:
- 状态标记(State Marking):
calcShardChange(在 Apply 协程中)只负责修改分片的元数据状态。将分片标记为 Pulling ,将需要被拉取的分片标记为BePulling。
- 状态执行(State Reconciliation): 启动一个独立的后台协程,不断轮询所有分片的状态。一旦发现某个分片处于
Pulling 状态,它就尝试发起数据拉取任务。
2. 永不停止的“拉取循环”
这个独立协程充当了“状态校准器”的角色。只要分片状态还不是 Serving,它就会不知疲倦地重试,直到成功为止。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
|
func (kv *ShardKV) shardMonitor() {
	for !kv.killed() {
		if kv.isLeader() {
			kv.mu.Lock()
			DPrintf(dFetch, "%v: detect shard needing pulling, len %d need pulling\n", kv, len(kv.needPulling))
			if len(kv.needPulling) > 0 {
				pullingMap := make(map[int]shardctrler.Config, len(kv.needPulling))
				for shardID, config := range kv.needPulling {
					pullingMap[shardID] = copyConfig(config)
				}
				kv.mu.Unlock()

				for shardID, config := range pullingMap {
					go kv.pullShardTask(shardID, &config)
				}
			} else {
				kv.mu.Unlock()
			}
		}
		time.Sleep(100 * time.Millisecond)
	}
}
|
当后台监控协程发现某个分片需要拉取时,会启动 pullShardTask。这个函数不仅负责网络通信,更关键的是要保证数据写入的安全性和一致性。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
|
func (kv *ShardKV) pullShardTask(shardID int, config *shardctrler.Config) {
	gid := config.Shards[shardID]

	args := FetchShardArgs{
		ConfigNum: config.Num, // 请求特定版本的数据
		Shard:     shardID,
	}

	servers, ok := config.Groups[gid]
	if !ok {
		panic(fmt.Sprintf("can't find gid{%d} from config.Groups", gid))
	}
	DPrintf(dFetch, "%v: is fetching shard %d\n", kv, shardID)

	for kv.isLeader() {
		reply := kv.getShardDataFromGroup(args, servers)

		if reply == nil || reply.Err != OK {
			time.Sleep(100 * time.Millisecond)
			continue
		}

		kv.mu.Lock()

		if kv.currentConfig.Num > config.Num+1 || kv.data[shardID].State != Pulling {
			kv.mu.Unlock()
			DPrintf(dFetch, "Stop pulling shard %d for config %d, current is %d (outdated) or already served/ready", shardID, config.Num, kv.currentConfig.Num)
			return // 直接放弃任务,退出循环
		}

		kv.mu.Unlock()

		op := InsertShardOp{
			ShardID:     shardID,
			ConfigNum:   config.Num + 1,    //这是为了变成新配置准备的数据
			ShardData:   reply.Data,        // 对方发来的 KV
			LastCommand: reply.LastCommand, // 对方发来的去重表
		}

		index, isLeader := kv.submitToRaft(op)
		if !isLeader {
			return
		}
		DPrintf(dFetch, "%v: is raft shard %d, index is %d\n", kv, shardID, index)
		if kv.waitRaft(index) == OK {
			return
		}

		time.Sleep(100 * time.Millisecond)
	}
}
|
主要包含三个核心步骤:
- RPC 拉取: 根据保存的旧配置(
config),向分片的前任持有者(Group)发送 FetchShard RPC。
- 二次状态检查 : 这是极易被忽略的关键点。 RPC 调用是一个耗时的网络操作,在请求返回期间,本地节点的配置可能已经更新,或者该分片已经被其他协程处理完了。因此,在拿到数据准备提交 Raft 之前,必须加锁再次检查:当前配置是否依然匹配?分片状态是否依然是
Pulling?如果状态变了,必须直接丢弃这份数据,防止“旧数据覆盖新数据”。
- 通过 Raft 达成共识 : 拉取到的不仅仅是 KV 数据,还有去重表(LastCommand / Session)。我们不能直接修改内存,而是将数据封装成
InsertShardOp 操作提交给 Raft。
作为数据的提供方,当收到 FetchShard 请求时,节点需要返回指定配置版本的分片数据。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
|
func (kv *ShardKV) FetchShard(args *FetchShardArgs, reply *FetchShardReply) {
	if !kv.isLeader() {
		reply.Err = ErrWrongLeader
		return
	}

	kv.mu.Lock()
	defer kv.mu.Unlock()

	shardData, exists := kv.historyData[args.ConfigNum][args.Shard]
	if !exists || shardData == nil {
		// 如果我这儿没有这个分片的数据 (可能已经被 GC 了,或者从未拥有过)
		reply.Err = ErrNoKey
		return
	}

	// DPrintf(dFetch, "%v: the shard %d fetch ask pass shard exist check\n", kv, args.Shard)

	// 深拷贝 KV 数据 (Deep Copy Data)
	reply.Data = make(map[string]string)
	for k, v := range shardData {
		reply.Data[k] = v
	}

	// 深拷贝去重表 (Deep Copy Duplicate Table)
	reply.LastCommand = make(map[int64]int)
	if lastOps, ok := kv.lastCommand[args.Shard]; ok {
		for clientID, seq := range lastOps {
			reply.LastCommand[clientID] = seq
		}
	}

	reply.Err = OK
}
|
当接收到raft传来的分片后,我们就可以进行接收了
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
|
case InsertShardOp:
// 幂等性检查
if command.ConfigNum == kv.currentConfig.Num && kv.data[command.ShardID].State == Pulling {
  shardID := command.ShardID

  DPrintf(dFetch, "%v: shardID %d pulling apply success \n", kv, shardID)
  kv.data[shardID].KV = make(map[string]string, len(command.ShardData))
  for k, v := range command.ShardData {
    kv.data[shardID].KV[k] = v
  }

  if _, ok := kv.lastCommand[shardID]; !ok {
    kv.lastCommand[shardID] = make(map[int64]int)
  }
  for k, v := range command.LastCommand {
    if kv.lastCommand[shardID][k] < v {
      kv.lastCommand[shardID][k] = v
    }
  }
  // 状态切换
  kv.data[shardID].State = Serving
  delete(kv.needPulling, shardID)
}
|
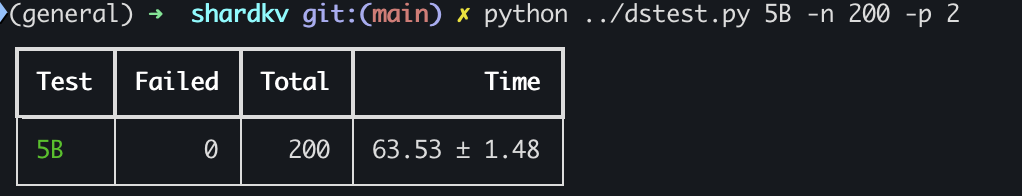
200次顺利通过。