这个部分就是在基于lab3的raft的基础上构建一个容错的、可复制的键值存储服务。其架构图在lab中也已经给出了,根据这个来做就可以了。
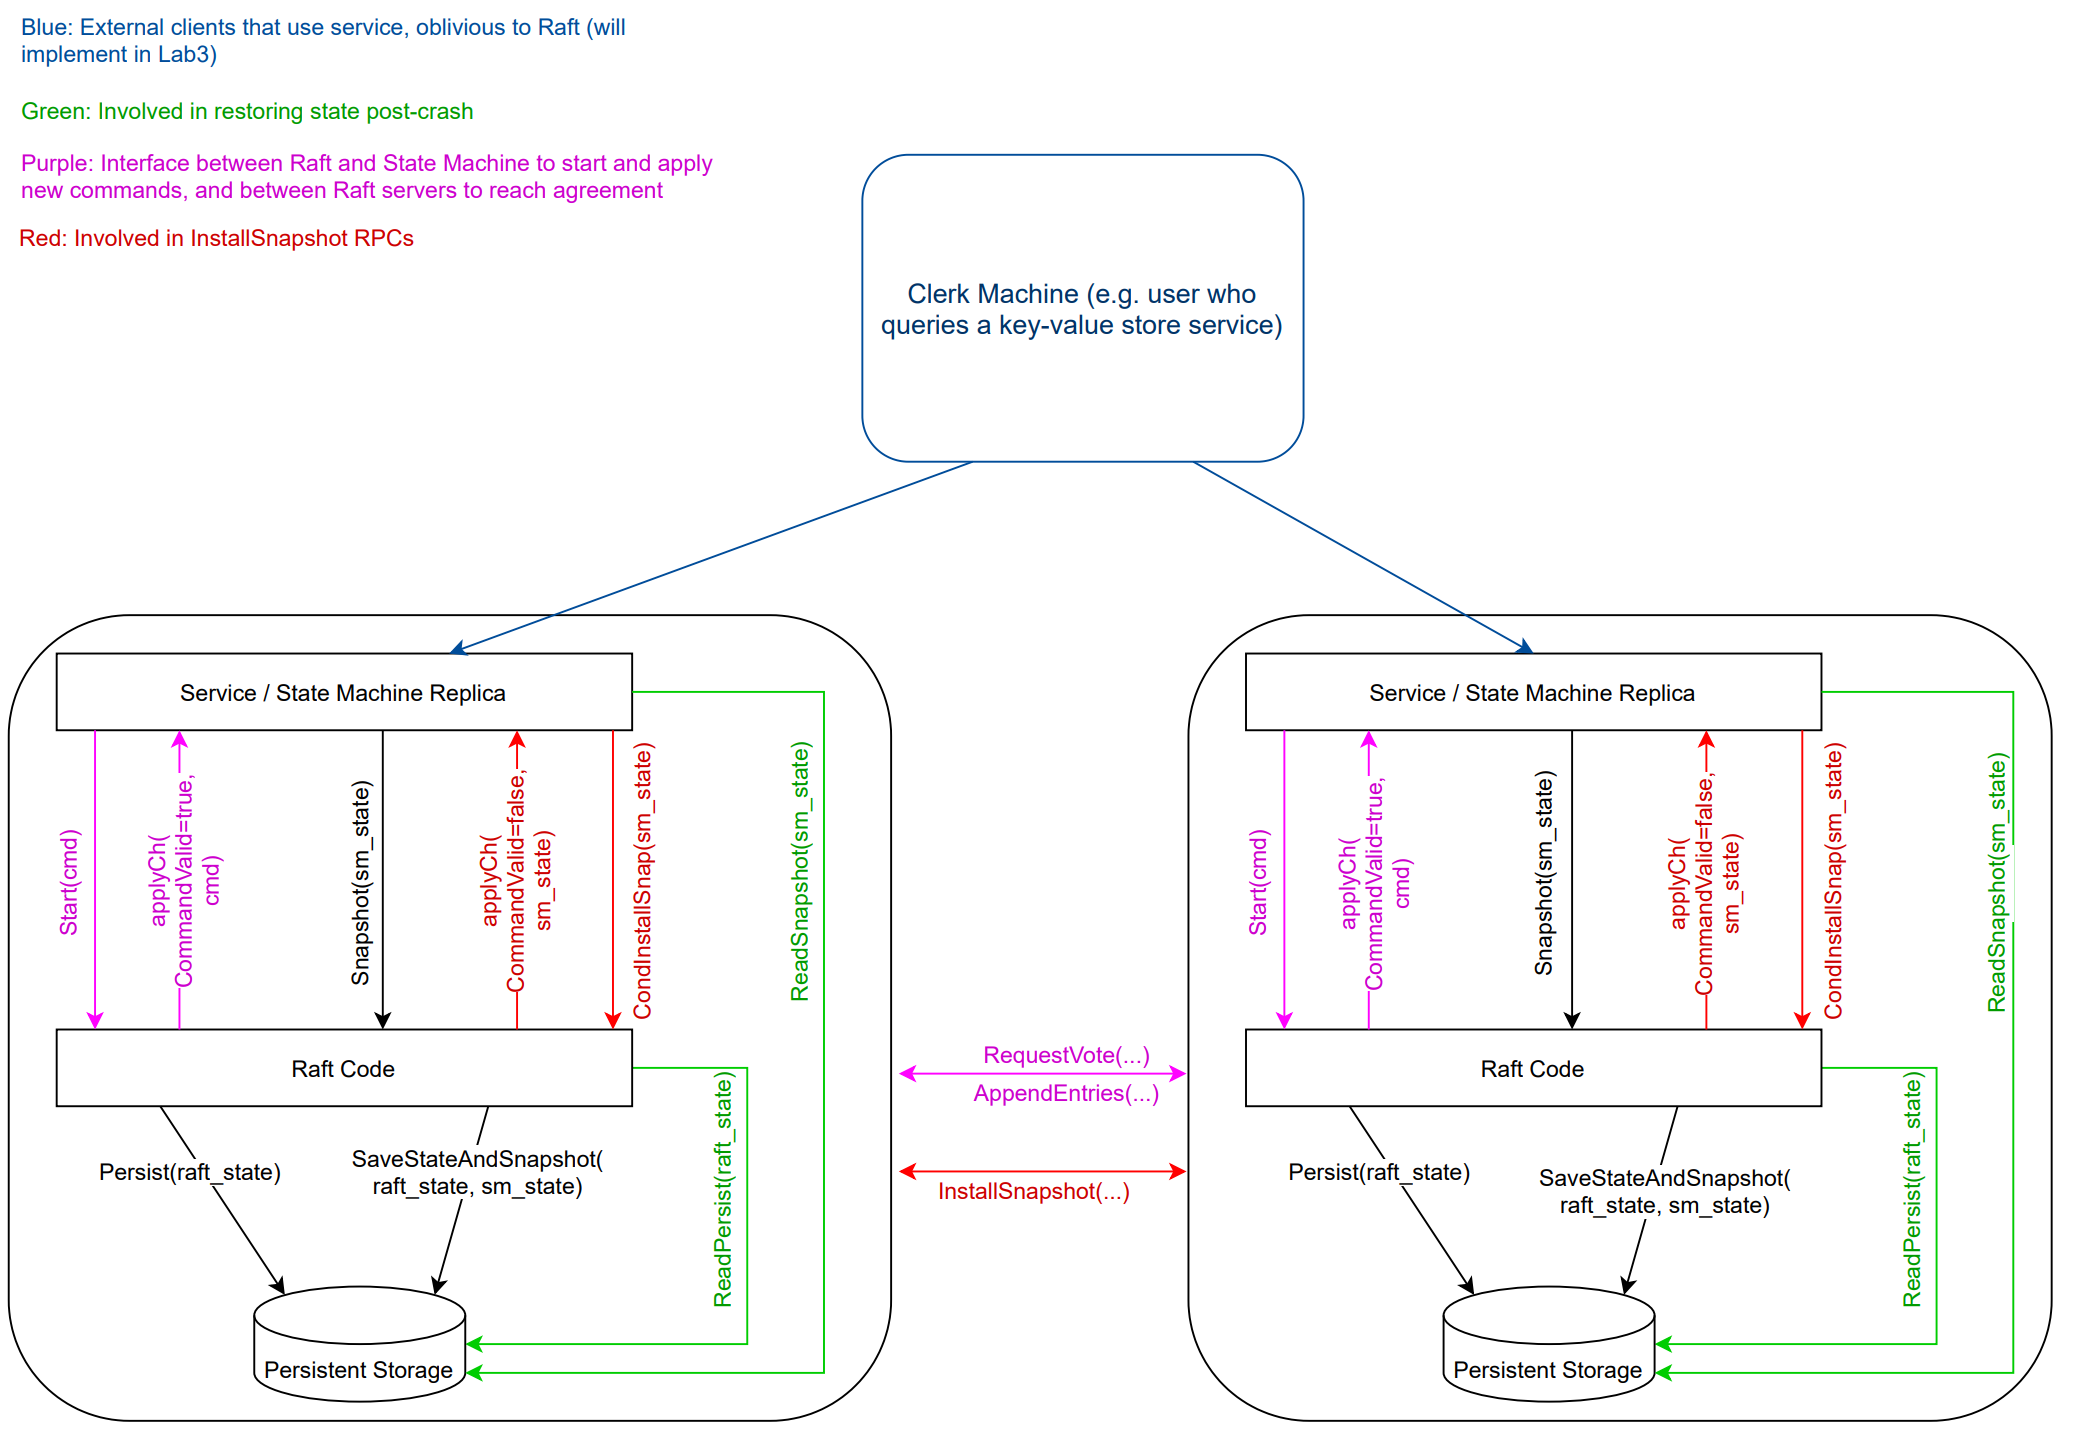
image-20251205152042524

Client

Client端的实现非常直观,和lab2的实现完全一样。本质上是一个屏蔽了网络故障和Leader切换的RPC重试循环。为了保证系统的线性一致性,每个客户端维护唯一的ClientID和单调递增的CommandID作为请求的唯一标识,每次发新的请求前要先把CommandID + 1,在收到明确的成功响应前,即便多次重试也保持CommandID不变,从而配合Server端进行去重。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
func (ck *Clerk) PutAppend(key string, value string, op string) {
	// You will have to modify this function.
	ck.CommandId += 1
	args := PutAppendArgs{Key: key, Value: value, ClientId: ck.ClientId, CommandId: ck.CommandId}

	for {
		reply := PutAppendReply{}
		if !ck.servers[ck.LeaderId].Call("KVServer."+op, &args, &reply) || reply.Err != OK {
			ck.LeaderId = (ck.LeaderId + 1) % len(ck.servers)
			time.Sleep(retryInterval)
			continue
		}
		break
	}
}

Server

KVServer 端的设计核心在于“共识层”与“状态机”的解耦协同。

也就是采用了**“异步提交 + 同步等待”**的模式:RPC Handler 收到请求后,调用 Raft 的 Start() 接口将命令写入日志,获得该日志的 index。由于 Raft 的共识过程是异步的,Handler 此时会创建一个通知通道(我在这里用的是waitCh),并以 index 为 Key 注册到等待列表中,随即阻塞等待。

同时,后台运行着一个ApplyLoop 协程,它充当了消费者角色,持续从 Raft 的 applyCh 中读取已达成共识的日志。一旦收到新日志,ApplyLoop 会将其应用到内存状态机(KV DB),并通过waitCh唤醒通知等待的handler说明日志已经完成共识,可以返回了,至此完成一次完整的请求处理。

NoOp

在 Raft 协议中,新 Leader 当选后,可能会面临一个尴尬的局面:日志中存在通过了“大多数”但尚未 Commit 的旧 Term 日志。根据 Raft 安全性规则,Leader 不能直接通过统计副本数来 Commit 之前 Term 的日志,必须等到当前 Term 有新的日志提交时,才会间接把前面的旧日志一并 Commit。

为了避免“死等”客户端请求来触发提交(这会导致状态机长时间滞后),我们需要引入 NoOp (No-Operation) 机制,该机制主要通过流转过程强行推动了 commitIndexlastApplied 的追赶。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
const (
	GetOp    = "GetOp"
	PutOp    = "PutOp"
	AppendOp = "AppendOp"
	NoOp     = "NoOp"
)

type Op struct {
	OpType    OperationType
	Key       string
	Value     string
	ClientId  int64
	CommandId int
}

func (kv *KVServer) sendNoOp() {
	for !kv.killed() {
		if kv.isLeader() {
			command := Op{OpType: NoOp}
			kv.submitToRaft(command)
		}
		time.Sleep(sendOpInterval)
	}
}

submit

submit主要就是采用一个超时等待的机制,我的实现采用了 Channel 机制 来实现这种超时等待,具体流程如下:

  1. 幂等性检查(Fast Path): 在提交 Raft 之前,先查阅去重表。如果该请求已经被执行过(可能因为网络延迟导致 Client 重试),直接从内存中返回结果,避免无意义的 Raft 交互。
  2. 注册通知通道: 调用 rf.Start() 获取日志 Index 后,创建一个缓冲 Channel 并注册到 waitCh 映射表中。
  3. 超时与结果校验: 使用 select 监听通道。这里有一个极其关键的细节:当 Channel 被唤醒时,必须再次校验 Op 的唯一标识(ClientID 和 CommandID)。

这里的一个易错点就在于第三点,很多人误以为 Raft 日志一旦写入就不会变。实际上,只有“已提交(Committed)”的日志才是不会变的。raft是会存在 “日志覆盖(Log Overwrite)” 的,即会存在以下情况:

  1. 当前 Server(Leader)在 index=100 处接收了 Client A 的请求,处于未提交状态。
  2. Server 发生网络分区或宕机,随后重新加入集群,但发现新 Leader 在 index=100 处已经提交了 Client B 的请求。
  3. 根据 Raft 协议,Server 会删除本地 index=100 的旧日志,同步 Client B 的新日志。
  4. 当 ApplyLoop 执行到 index=100 时,它会通知 waitCh[100]

如果不进行 result.ClientId != command.ClientId 的校验,Client A 的 RPC 协程会被唤醒,并错误地认为自己的操作成功了(实际上执行的是 B 的操作)。这个点让我debug了好久😭,这里我也看了比人的实现,用term进行检验也是可以的。

apply loop

KVServer 需要启动一个后台协程(Apply Loop),持续监听 Raft 传来的 applyCh,其核心职责是将 Raft 达成共识的日志确定性地转化为实际的数据库状态。这个过程主要包含三个关键环节:

  1. 命令应用与幂等性检查: 当收到新的 CommandValid 日志时,首先过滤掉 NoOp(空操作)。对于有效的客户端命令,我们必须进行严格的去重检查(Deduplication):查询 lastCommand 表,确认该命令是否已被执行。只有未执行过的命令才会被应用到内存数据库中,从而保证线性一致性(Linearizability)
  2. 日志压缩(Log Compaction): 为了防止 Raft 日志无限膨胀导致磁盘耗尽或重启缓慢,我们在每次处理完命令后都会检查 Raft 的持久化状态大小。一旦接近预设阈值(maxraftstate),应用层会主动调用 kv.snapshot() 生成快照,通知 Raft 截断并丢弃旧日志。
  3. 快照安装(Snapshot Installation):applyCh 传来的是 SnapshotValid 消息时,意味着需要重置状态机(通常发生在节点重启或严重落后时)。此时必须进行一项关键的安全检查:比较快照的 Index 与当前的 lastAppliedIndex。只有当快照的 Index 严格大于 当前应用索引时,才进行状态替换。这有效防止了网络延迟导致的“旧快照覆盖新状态”问题,确保状态机只能向前演进。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
func (kv *KVServer) recivedApplyChan() {
	for ch := range kv.applyCh {
		if kv.killed() {
			break
		}
		kv.mu.Lock()

		if ch.SnapshotValid {
			snapShotData := ch.Snapshot
			index := ch.SnapshotIndex

			if index <= kv.lastAppliedIndex {
				kv.mu.Unlock()
				continue
			}

			kv.readSnapshot(snapShotData)
			kv.lastAppliedIndex = index
		} else if ch.CommandValid {
			command := ch.Command.(Op)
			index := ch.CommandIndex

			if command.OpType != NoOp {
				if !kv.isApplied(&command) {
					kv.lastCommand[command.ClientId] = command.CommandId
					kv.addTodata(&command)
				}

				value := ""
				if command.OpType == GetOp {
					value = kv.data[command.Key]
				}
				kv.notify(index, &command, value)
			}

			if kv.maxraftstate != -1 {
				threshold := int(float64(kv.maxraftstate) * 0.9)
				kv.lastAppliedIndex = index

				if kv.persister.RaftStateSize() >= threshold {
					kv.snapshot()
				}
			}
		}
		kv.mu.Unlock()
	}
}

Snapshot

当 Raft 日志增长到一定程度时,为了释放磁盘空间并缩短重启后的恢复时间,我们需要将当前的状态机“存档”为快照。这一过程主要涉及数据的序列化与反序列化,核心在于明确**“哪些数据是必须保存的”**。

持久化数据的定义(The PersistData): 在生成快照时,我定义了一个 PersistData 结构体,它必须包含两部分核心数据,缺一不可:

  • Data (KV 数据表): 这是数据库的当前状态(即所有的 Key-Value 对)。保存它是为了在重启后能够恢复用户写入的数据,这是快照最基本的功能。
  • LastCommand (去重表): 这是保证线性一致性的关键。在系统重启恢复快照后,我们不仅要恢复数据,还要恢复“去重状态”。如果丢失了这张表,Server 重启后就无法识别快照之前已经执行过的命令,导致客户端的重试请求被重复执行(At-Least-Once),从而破坏了系统的一致性。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
type PersistData struct {
	Data        map[string]string
	LastCommand map[int64]int
}

func (kv *KVServer) snapshot() {
	w := new(bytes.Buffer)
	e := labgob.NewEncoder(w)

	sanpshotData := PersistData{
		Data:        kv.data,
		LastCommand: kv.lastCommand,
	}

	e.Encode(sanpshotData)
	kvstate := w.Bytes()

	kv.rf.Snapshot(kv.lastAppliedIndex, kvstate)
}

func (kv *KVServer) readSnapshot(snapshotData []byte) {
	if snapshotData == nil {
		return
	}

	r := bytes.NewBuffer(snapshotData)
	d := labgob.NewDecoder(r)

	var data PersistData

	if d.Decode(&data) != nil {
		return
	}

	kv.data = data.Data
	kv.lastCommand = data.LastCommand
}

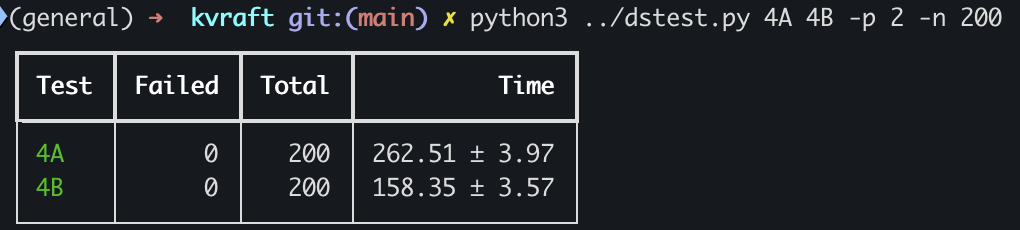
最后也是顺利通过了200次的测试:

lab4